Einführung
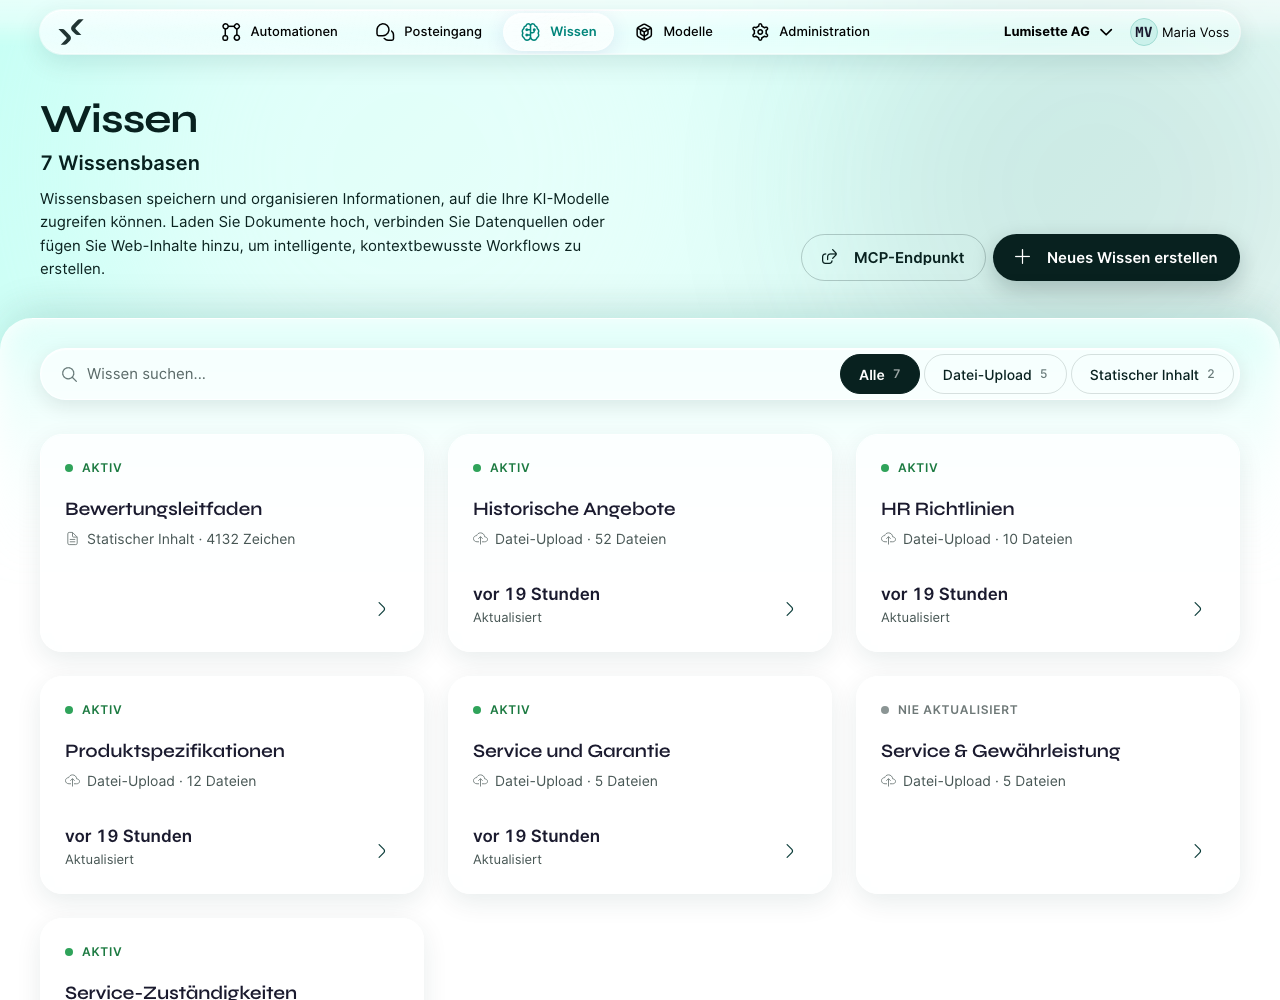
Eine Wissensbasis ist Ihre eigene Sammlung von Dokumenten, die ein KI-Modell durchsuchen kann. Fügen Sie das Mitarbeiterhandbuch, die Produktspezifikation, Ihre FAQs oder aus dem Web abgerufene Inhalte hinzu – alles, was auf Text beruht. Ab dann können Automationen Fragen dazu beantworten.
Dieser Abschnitt erklärt die Idee, führt Sie durch den Aufbau einer Wissensbasis und zeigt, wie Sie sie aktuell halten.
Warum eine Wissensbasis hilft
Ein KI-Modell weiß von Haus aus nur, was es im Training gelernt hat. Es kennt weder Ihr Unternehmen noch Ihre Produkte, Prozesse oder Richtlinien. Das lässt sich auf zwei Wegen ändern:
- Alles in den Prompt schreiben. Funktioniert bei sehr kleinen Textmengen. Scheitert bei jedem realistischen Umfang: zu teuer, zu langsam, sprengt die Kontextgrenzen.
- Eine Wissensbasis verwenden. Die Dokumente werden gespeichert und indexiert; bei einer Anfrage werden nur die wenigen Textstellen abgerufen, die tatsächlich relevant sind. Diese Textstellen gehen zusammen mit dem Prompt an das Modell.
Den zweiten Ansatz nennt man Retrieval-Augmented Generation (RAG). Im AI Kit heißt er Wissen. Er ist der empfohlene Weg, KI-Antworten auf Ihre eigenen Daten zu stützen.
Was in eine Wissensbasis gehört
Fast jeder Text:
- Dokumente – Word-Dateien, PDFs, Markdown, reiner Text.
- Webinhalte – öffentliche Webseiten, interne Wikis (sofern per HTTP erreichbar).
- Datenbankzeilen – für strukturierte Daten, oft über einen Workflow, der Zeilen als Text exportiert.
- Ordner im Dateisystem – richten Sie eine Wissensbasis auf ein Verzeichnis aus, und sie übernimmt alles, was darin liegt.
Jede Wissensbasis hat eine oder mehrere Quellen. Jede Quelle ist ein Connector – eine Ordnerüberwachung, ein HTTP-Abruf, ein Datenbankleser –, der weiß, wie er Daten einliest. Sie können Quellen innerhalb einer Wissensbasis kombinieren; die Plattform kümmert sich um Deduplizierung und Neuindexierung.
Wie eine Wissensbasis genutzt wird
Ruft ein Schritt einer Automation (etwa Wissensabfrage oder KI-Aktion) eine Wissensbasis ab, passiert dreierlei:
- Das Embedding-Modell der Wissensbasis wandelt die Anfrage in einen Vektor um.
- Die Plattform vergleicht den Anfragevektor mit den Vektoren aller Chunks der Wissensbasis.
- Die besten Treffer werden zurückgegeben, mit dem zugehörigen Text und (meist) einer Quellenangabe.
Der Abgleich ist semantisch: Eine Anfrage zu „Urlaubsregelung“ kann ein Dokument mit dem Titel „Handbuch Jahresurlaub“ finden, weil das Embedding-Modell versteht, dass beides dasselbe meint.
Wichtige Begriffe
| Begriff | Bedeutung |
|---|---|
| Quelle | Ein Connector, der Inhalte in die Wissensbasis einliest. |
| Chunk | Ein Teil eines Dokuments, den die Plattform eigenständig durchsuchen kann. Lange Dokumente werden in viele Chunks zerlegt. |
| Embedding-Modell | Das Modell, das Chunks in Vektoren umwandelt. Dasselbe Modell wird zur Laufzeit für Anfragen verwendet. |
| Aktualisierung | Der Vorgang, bei dem Quellen neu gelesen und Chunks neu indexiert werden. Quellen können nach Zeitplan oder bei Bedarf aktualisiert werden. |
| Abrufstrategie | Wie die Plattform entscheidet, welche Chunks zurückgegeben werden. Die meisten Wissensbasen nutzen die Standardstrategie („standard“) und müssen sie nie ändern. |
Wann mehr als eine Wissensbasis sinnvoll ist
Eine einzelne Wissensbasis kann viele Inhalte aufnehmen. Der Grund für eine Aufteilung ist der Zuschnitt:
- Eine Wissensbasis je Produktlinie – damit der Kundenservice-Agent gezielt die richtige nutzen kann.
- Eine Wissensbasis je Zielgruppe – interne oder externe Dokumentation.
- Eine Wissensbasis je Sprache – wenn Sie Inhalte in mehreren Sprachen pflegen.
Im Zweifel beginnen Sie mit einer und teilen später auf.
Nächste Schritte
- Wissensbasen erstellen und bearbeiten – Schritt für Schritt.
- Wissensdaten aktualisieren – Inhalte aktuell halten.
- Zur Nutzung in Automationen siehe Wissensabfrage und KI-Aktion.